In diesem Artikel
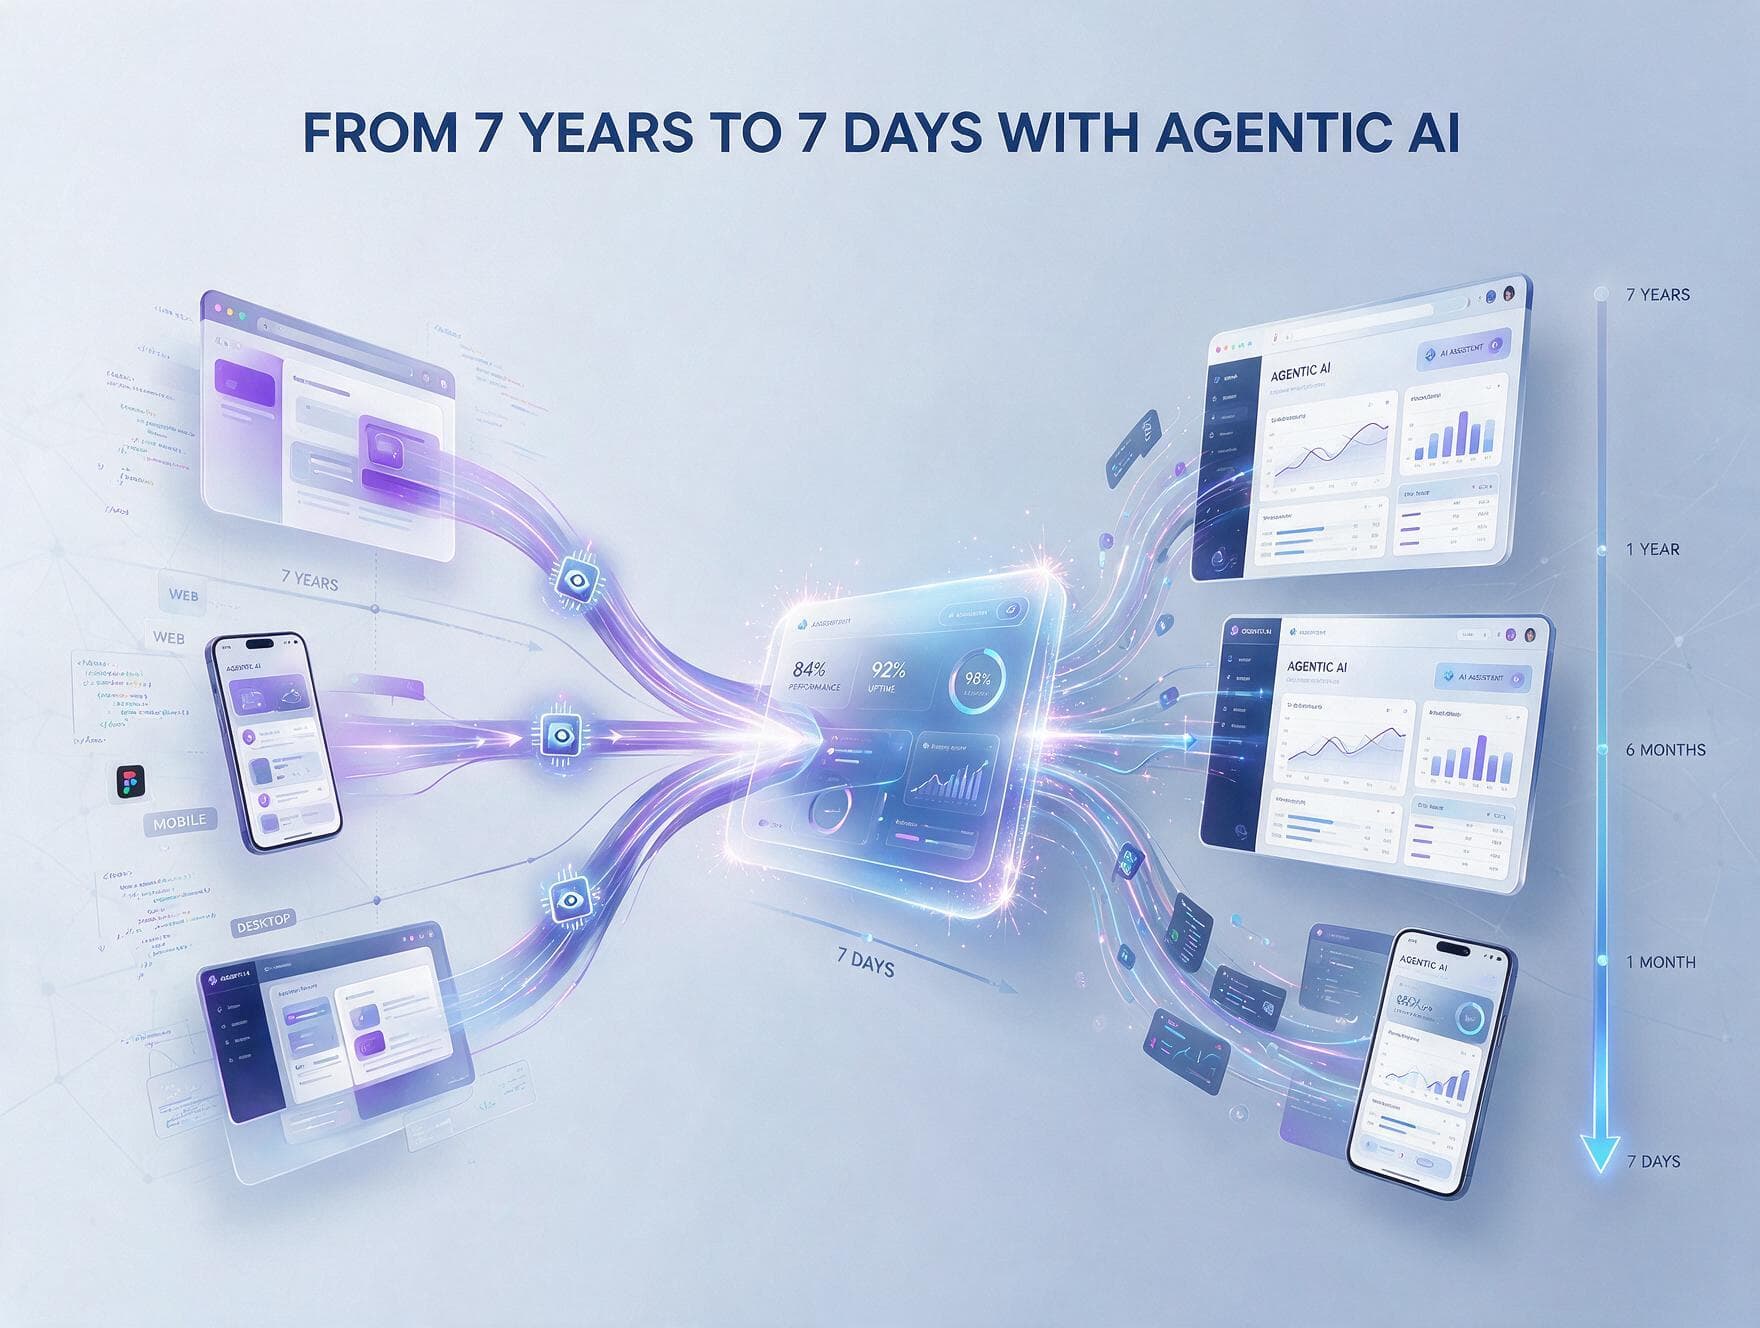
Wenn Sie schon einmal vor einer COCOMO-II-Tabelle saßen und zusehen mussten, wie sie 33 Kalendermonate für ein Projekt vorhersagt, das Ihr Team in zwei Sprints ausgeliefert hat, kennen Sie das Problem bereits: Jedes heute eingesetzte Schätzmodell wurde in einer Welt kalibriert, in der Entwickler jede Zeile selbst tippen, jeder Kontextwechsel Zeit kostet und der Kalender um 17 Uhr stehen bleibt. Diese Welt gibt es nicht mehr. Wir haben kürzlich eine Anwendung mit 286 KLOC, 672 Dateien und mehreren Subsystemen von Grund auf entwickelt, mit Protokollschicht, Datenschicht, Rendering-Engine und Plattformintegration, und nach 7 Tagen eine testbereite Alphaversion erreicht. Das vollständige Modellpanel (COCOMO Basic/Intermediate/Post-Architecture, Function Points, SLOC-Baseline, Putnam/SLIM) ergab eine mittlere Prognose von 30,3 Kalendermonaten. Der mittlere Produktivitätsfaktor: 4.240×. Selbst die konservativste Baseline (25 SLOC pro Entwicklertag für komplexe Systeme) lag um den Faktor 1.433× daneben. Die Modelle sind nicht falsch. Sie werden falsch angewendet. Im Folgenden finden Sie die Aufschlüsselung Modell für Modell, die empirische Kalibrierung am selben Autor und das, was die RCT-Literatur der Jahre 2024 bis 2026 tatsächlich darüber sagt, wo agentische KI die Dauer verkürzt und wo nicht.
Das Projekt, das die Schätzungen sprengte
Bei RIADVICE haben wir kürzlich eine komplexe, funktionsreiche Anwendung entwickelt, eine von der Art, die mehrere Subsysteme über eine verteilte Architektur hinweg koordiniert, als native plattformübergreifende Umgebung für Mobilgeräte und Desktop aus einer einzigen Codebasis. Anlass waren Marktanforderungen, die eine neue Implementierung verlangten. Die Codebasis zeigt die Größenordnung:
- 286.662 SLOC (ca. 286 KLOC), verteilt auf 672 Quelldateien
- 1.329.399 Zeilen Gesamt-Churn: 862.488 Einfügungen und 466.911 Löschungen
- 700 Commits an 7 aktiven Entwicklungstagen bis zur ersten testbereiten Alphaversion
- Vollständige Internationalisierung in Dutzende Sprachen
- Mehrere voneinander völlig unabhängige Subsysteme, nämlich Protokollverarbeitung, Datenverwaltung, Rendering und Plattformintegration, alle für die Zielumgebung von Grund auf neu gebaut
Das war weder ein Wrapper noch ein dünnes neues Gewand. Es war eine von Grund auf native Implementierung, gebaut, um Marktanforderungen zu erfüllen, die bestehende Lösungen nicht erfüllen konnten. Bevor ich eine einzige Zeile schrieb, band ich ein eigenes Analysewerkzeug in das Projekt ein, das das vollständige Panel branchenüblicher Modelle zur Schätzung des Softwareaufwands auf die wachsende Codebasis anwendet. Das Ziel war ehrlich: die Lücke messen zwischen dem, was klassische Modelle vorhersagen, und dem, was eine KI-gestützte Entwicklung tatsächlich liefert. Die Ergebnisse sind kein Rundungsfehler. Sie sind ein Kategorienbruch.
Was die Schätzmodelle vorhersagten und was tatsächlich geschah
Das Werkzeug führt jedes wichtige Schätzmodell der Software-Engineering-Literatur aus, also COCOMO Basic (Organic, Semi-Detached, Embedded), COCOMO Intermediate (Semi-Detached und Embedded, abgestimmt), COCOMO II Post-Architecture (abgestimmt), Function Points, die SLOC-Produktivitäts-Baseline und Putnam/SLIM, jeweils auf den Projekttyp kalibriert mit den veröffentlichten Konstanten aus der Originalliteratur.
| Schätzmodell | Prognostizierter Aufwand | Prognostizierte Dauer | Beschleunigung ggü. Ist |
|---|---|---|---|
| COCOMO Basic (Organic) | 913 Personenmonate | 33,3 Monate | 2.282× |
| COCOMO Basic (Semi-Detached) | 1.696 Personenmonate | 33,7 Monate | 4.240× |
| COCOMO Basic (Embedded) | 3.200 Personenmonate | 33,1 Monate | 8.000× |
| COCOMO Intermediate (Semi-Det., abgestimmt) | 1.259 Personenmonate | 30,4 Monate | 3.148× |
| COCOMO Intermediate (Embedded, abgestimmt) | 2.376 Personenmonate | 30,1 Monate | 5.940× |
| COCOMO II Post-Architecture (abgestimmt) | 1.703 Personenmonate | 30,3 Monate | 4.257× |
| Function Points (Überschlagsrechnung) | 17,9 Personenmonate | 7,5 Monate | 45× |
| SLOC-Produktivitäts-Baseline (25 SLOC/Entwicklertag) | 573 Personenmonate | 573,3 Monate | 1.433× |
| Putnam/SLIM | übersprungen (Dauer < 30 Tage; T 4/3 explodiert) | entfällt | entfällt |
Der mittlere Produktivitätsfaktor über alle Modelle beträgt 4.240×. Selbst das konservativste Modell sagt eine rund 1.400-mal längere Lieferzeit voraus, als tatsächlich benötigt wurde. Das optimistischste, Function Points, prognostizierte immer noch 7,5 Kalendermonate, also 45-mal länger als die tatsächlichen 7 Tage. Laut den Modellen hätte dieses Projekt zwischen 7 Monaten und 47 Jahren dauern müssen. Eine Alphaversion war nach 7 Tagen testbereit.
Die Modelle widersprechen einander um den Faktor 50 bis 8.000
Diese Modelle sind sich untereinander nicht einig. Für dieselbe Codebasis reichen die Prognosen von 17,9 bis 3.200 Personenmonaten, eine Spreizung um den Faktor 178. Der SEAA-Benchmark 2013 zu COCOMO II, SEER-SEM, SLIM und TruePlanning über 51 reale Projekte ergab einen MMRE von 50 bis 100 %. Eine Auswertung des COCOMO-NASA-Datensatzes aus dem Jahr 2023 ergab einen MMRE von nahezu 1,0 und PRED(0.25) = 0,0: Kein einziges Projekt wurde innerhalb der Fehlermarge von 25 % geschätzt. Die Modelle waren nie für ein KI-gestütztes Projekt gedacht. Doch die Größe der Lücke zeigt, selbst wenn man die Ungenauigkeit der Modelle berücksichtigt, dass sich etwas Grundlegendes verändert hat.
Was die Forschung wirklich über agentische KI und Entwicklerproduktivität sagt
Der Wert von 4.240× ist extrem, und ich will ihn nicht überbewerten. Greenfield-Gerüstcode bläht den Churn auf, und SLOC sind ein schwacher Indikator für Wert. Werfen wir also einen Blick in die begutachtete Literatur. Assistenten im Stil von Copilot bringen moderate, aber echte Gewinne. Peng et al. (2023) stellten fest, dass Entwickler mit einem KI-Pair-Programmer eine Aufgabe 55,8 % schneller erledigten (95-%-KI: 21 bis 89 %). Das RCT von Microsoft, Accenture und einem Fortune-100-Unternehmen (2025), die bislang größte Studie mit n = 4.867, ergab 26 % mehr abgeschlossene Aufgaben. Googles internes RCT (2024) ergab eine um ca. 21 % kürzere Bearbeitungszeit. Das Feldexperiment von BIS und Ant Group (2024) maß 55 % mehr Code-Output bei Nachwuchskräften. Die ehrliche Zusammenfassung: Faktor 1,26 bis 1,56 bei geeigneten Aufgaben. Real, aber nicht umwälzend. Agentische KI bewegt sich in einer anderen Liga. Cognitions Rückblick auf Devin 2025 berichtete von Kundenergebnissen mit 10× bei ETL-Migrationen, 14× bei Java-Versionsmigrationen und 20× bei Sicherheitskorrekturen. Nubank meldete eine 12-fache Effizienzsteigerung und 20-fache Kosteneinsparungen bei einem Refactoring von mehreren Millionen Zeilen, das zuvor auf mehrere Jahre und tausend Ingenieure geschätzt worden war. Unsere Portierung liegt genau in diesem Bereich: Das Commit-Histogramm zeigt dichte Schübe um 22:00, 0:00 und 1:00 Uhr, die typische Signatur agentengesteuerter Sitzungen. Die Gegenbelege sind real. Das RCT von Metr.org aus dem Jahr 2025 (16 erfahrene Entwickler, 246 Aufgaben in ausgereiften Projekten) ergab, dass KI die Bearbeitungszeit um 19 % verlängerte: Sie bremste erfahrene Entwickler in vertrauten Codebasen aus. Eine Differenz-von-Differenzen-Studie aus dem Jahr 2026 über 807 GitHub-Repositorys, die KI-Werkzeuge eingeführt hatten (He et al., MSR ’26), fand einen „vorübergehenden“ Geschwindigkeitsschub und eine „anhaltende“ Zunahme der Codekomplexität, die langfristig zu einer Verlangsamung führte. Der Titel sagt alles: Speed at the Cost of Quality. Der Konsens: KI hilft viel bei Greenfield- und strukturierter Entwicklung, moderat bei Vervollständigungsaufgaben und kann die Geschwindigkeit in ausgereiften Codebasen verringern. Die Qualitätsschuld ist real.
Warum die Modelle versagen: drei strukturelle Verschiebungen
Keiner der Kostentreiber klassischer Modelle hat eine Einstellung für „der Entwickler verfügt über einen autonomen Agenten, der nie schläft und die gesamte Codebasis im Kontext hält“. Drei Verschiebungen lassen die Dauerkurve in sich zusammenfallen:
- Der Engpass Tippen ist verschwunden.
Die Modelle gehen davon aus, dass ein erheblicher Teil des Aufwands mechanisch ist: Boilerplate, Gerüstcode, sich wiederholende Refactorings, Lokalisierungsressourcen und andere strukturierte Daten. Bei dieser Portierung besteht ein Großteil des Volumens aus sehr regelmäßigem Text und Verdrahtung, die ein Agent in großen Mengen erzeugen oder umwandeln kann. Auch der eigentlich handgeschriebene Code, also Gerüste, Konstruktoren und Plattform-Glue, wird jetzt schubweise generiert und nicht mehr Zeile für Zeile getippt.
- Die Kosten des Kontextwechsels brechen ein.
Ein Mensch, der zwischen Protokollschicht, Datenschicht und Rendering-Engine wechselt, zahlt jedes Mal einen Preis, um sich wieder einzuarbeiten. Ein Agent, der das gesamte Repository mit 672 Dateien gelesen hat, zahlt ihn nur einmal. Diese Asymmetrie summiert sich bei einer Codebasis dieser Größe schnell.
- Der Kalender ist nicht mehr der Engpass.
Die Modelle rechnen Personenmonate über eine Personalgleichung in Kalendermonate um, die einen menschlichen Arbeitstag voraussetzt. Agentensitzungen laufen über Nacht. Das Commit-Histogramm zeigt anhaltenden Output von 7:00 bis 1:00 Uhr: 18 aktive Stunden statt 8.
Die empirische Kalibrierung am selben Autor
Da sich parametrische Modelle um Größenordnungen widersprechen, habe ich zusätzlich eine empirische, projektübergreifende Kalibrierung durchgeführt. Sie vergleicht meinen eigenen Code-Churn pro Personentag vor und nach der Einführung eines agentischen KI-Werkzeugs in drei weiteren Produktiv-Repositorys desselben Ökosystems:
| Projekt | Churn/Entwicklertag vor KI | Churn/Entwicklertag mit KI | Faktor |
|---|---|---|---|
| Projekt A (Load Balancer) | 673 | 2.056 | 3,1× |
| Projekt B (Reporting-Dienst) | 239 | 2.127 | 8,9× |
| Projekt C (Verarbeitungsdienst) | 1.322 | 982 | 0,7× |
| Gesamt (Durchschnitt / Median) | k. A. | k. A. | 4,2× / 3,1× |
Derselbe Autor, dieselbe Domäne, echte Wartungsarbeit. Der empirische Faktor liegt bei 3 bis 9×, weit konservativer als der Greenfield-Wert von 4.240× und im Einklang mit dem oberen Ende der veröffentlichten Forschung zu agentischer KI. Ein Projekt wurde sogar langsamer: Die Gewinne hängen von der Aufgabe ab und gelten nicht allgemein.
Was das für die Projektplanung bedeutet
Wer Softwareprojekte noch mit unkalibrierten Modellen und einer Baseline von 25 SLOC pro Tag schätzt, liegt bei KI-gestützter Arbeit um eine bis drei Größenordnungen daneben. So gehen wir bei RIADVICE vor:
- Kalibrieren Sie anhand Ihrer eigenen Historie. Vergleichen Sie Ihren eigenen Code-Output pro Personentag mit und ohne KI. Das ist günstiger, ehrlicher und liefert eine Spanne von 3 bis 9×, die Sie in einem Projektplan vertreten können.
- Trennen Sie Greenfield von Wartung. Der Faktor agentischer KI ist bei Greenfield- und strukturierter Entwicklung am größten und bei der Wartung ausgereifter Codebasen am kleinsten (mitunter sogar negativ). Wenden Sie nicht eine einzige Zahl auf beides an.
- Planen Sie ein Budget für Qualitätsschulden ein. Die Geschwindigkeit durch KI geht mit einer anhaltend steigenden Komplexität einher. Planen Sie eine Stabilisierungsphase ein und messen Sie sie: Verfolgen Sie die zyklomatische Komplexität und führen Sie bei jedem Release eine Erkennung von Code-Duplikaten durch.
- Schätzen Sie die ganze Kurve, nicht nur ihren Anfang. Ein 10-facher Geschwindigkeitsgewinn, der Ihre Fehlerdichte verdoppelt, ist kein 10-facher Gewinn, sondern ein vorgezogener Zeitplan, der mit einer längeren Stabilisierungsphase bezahlt wird.
Fazit
Ein Projekt, für das jedes Schätzmodell 7 Monate bis 47 Jahre vorhersagt, hat nach 7 Tagen eine testbereite Alphaversion erreicht. Der mittlere Faktor von 4.240× sollte in keinen Projektplan einfließen. Er ist aber ein klares Signal dafür, dass die Dauer komplexer Softwareentwicklung von derselben Kraft gestaucht wird, die auch den Aufwand staucht. Die veröffentlichte Forschung zeigt, dass KI alles zwischen einem leichten Schub um den Faktor 1,26 und einem Sprung um den Faktor 20 liefert, mit einem realen Risiko negativer Erträge in ausgereiften Codebasen und einem messbaren Qualitätspreis. Die Modelle, nach denen dieses Projekt Jahrzehnte hätte dauern sollen, sind dieselben, die noch heute in den Schätztabellen von Unternehmen laufen. Die Frage ist nicht, ob agentische KI die Projektdauer verändert, darauf hat die Forschung geantwortet. Die Frage ist, ob Ihre Schätzpraxis mit den Belegen Schritt gehalten hat. Wenn Ihre Zahlen noch aus einem Modell von 1981 stammen, das an COBOL und Assembler kalibriert wurde, ist es Zeit für eine Neukalibrierung, oder zumindest dafür, dem Kalender, den es ausgibt, nicht mehr zu glauben.
„Es gibt noch erheblichen Verbesserungsbedarf, um die Prognoseherausforderungen der Praxis besser zu bewältigen.“
Accuracy of Contemporary Parametric Software Estimation Models, SEAA 2013
🏆 Verlässliches Engineering und Cloud-Expertise
RIADVICE: Ihr verlässlicher Partner für Softwareentwicklung
Wir entwerfen, bauen und betreiben komplexe Softwaresysteme mit der Ingenieursdisziplin und den Werkzeugen, die es braucht, um im KI-Zeitalter zu liefern: termingerecht, im Budget und in der geforderten Qualität.
Mehr über unsere Leistungen erfahren
📚 Quellen und weiterführende Literatur
Dieser Artikel stützt sich auf begutachtete Forschung, randomisierte kontrollierte Studien und Praxisberichte aus der Industrie zur Produktivität KI-gestützter Softwareentwicklung und zur Schätzung des Softwareaufwands:
- Studien zur KI-Produktivität (RCTs und Feldexperimente)
- Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot, arXiv:2302.06590: 55,8 % kürzere Bearbeitungszeit
- Cui, R., et al. (2025). The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers Microsoft Research: n = 4.867, +26,08 % abgeschlossene Aufgaben
- Dam, S., et al. (2024). How much does AI impact development speed? An enterprise-based randomized controlled trial, arXiv:2410.12944: RCT bei Google, n = 96, ca. 21 % kürzere Bearbeitungszeit
- Becker, B., et al. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity Metr.org: RCT, n = 16, 246 Aufgaben; KI verlängerte die Bearbeitungszeit um 19 %
- He, H., Miller, C., Agarwal, S., Kästner, C., & Vasilescu, B. (2026). Speed at the Cost of Quality: How Cursor AI Increases Short-Term Velocity and Long-Term Complexity in Open-Source Projects, arXiv:2511.04427: Differenz-von-Differenzen-Studie über 807 GitHub-Repositorys; MSR ’26
- Evolver Business Solutions (2026). For a few tokens more: The productivity effect of AI tools on software development tasks Replikation mit +13 % (nicht signifikant)
- Branchenberichte zu agentischer KI
- Cognition AI (2025). Devin’s 2025 Performance Review: Learnings From 18 Months of Agents At Work 10× bei ETL-Migrationen, 14× bei Java-Migrationen, 20× bei Sicherheitskorrekturen
- Nubank / Cognition. How Nubank refactors millions of lines of code to improve engineering efficiency with Devin 12× bei Ingenieursstunden, 20× Kosteneinsparung bei einem Refactoring von mehreren Millionen Zeilen
- BIS / Ant Group (2024). Feldexperiment; +55 % Code-Output, vor allem bei Nachwuchskräften
- Schätzung des Softwareaufwands: Grundlagen und Genauigkeit
- Boehm, B. W. (1981). Software Engineering Economics. Prentice Hall: das ursprüngliche COCOMO
- Boehm, B. W., Abts, C., & Chulani, S. (2000). Software Cost Estimation with COCOMO II. Prentice Hall: kalibriert an 161 Projekten
- SEAA 2013. Accuracy of Contemporary Parametric Software Estimation Models COCOMO II, SEER-SEM, SLIM und TruePlanning über 51 Projekte; MMRE 50 bis 100 %
- Kemerer, C. F. (1993). An empirical validation of software cost estimation models, Communications of the ACM
- Nguyen, V., et al. (2019). Determining relevant training data for effort estimation using window-based COCOMO calibration Fensterbasierte Kalibrierung über 341 + 93 Projekte
- Ahmad, M., & Wani, M. A. (2023). Evaluation of COCOMO Model Accuracy in Software Effort Estimation MMRE ca. 1,0, PRED(0.25) = 0,0
- Putnam, L. H. (1978). A general empirical solution to the macro software sizing and estimation problem. IEEE TSE: das Putnam/SLIM-Modell
⚡ RIADVICE.com steht für verlässliches Engineering, Cloud-Expertise und Softwarelösungen auf Unternehmensniveau: termingerecht, im Budget und in der geforderten Qualität.