Dalam artikel ini
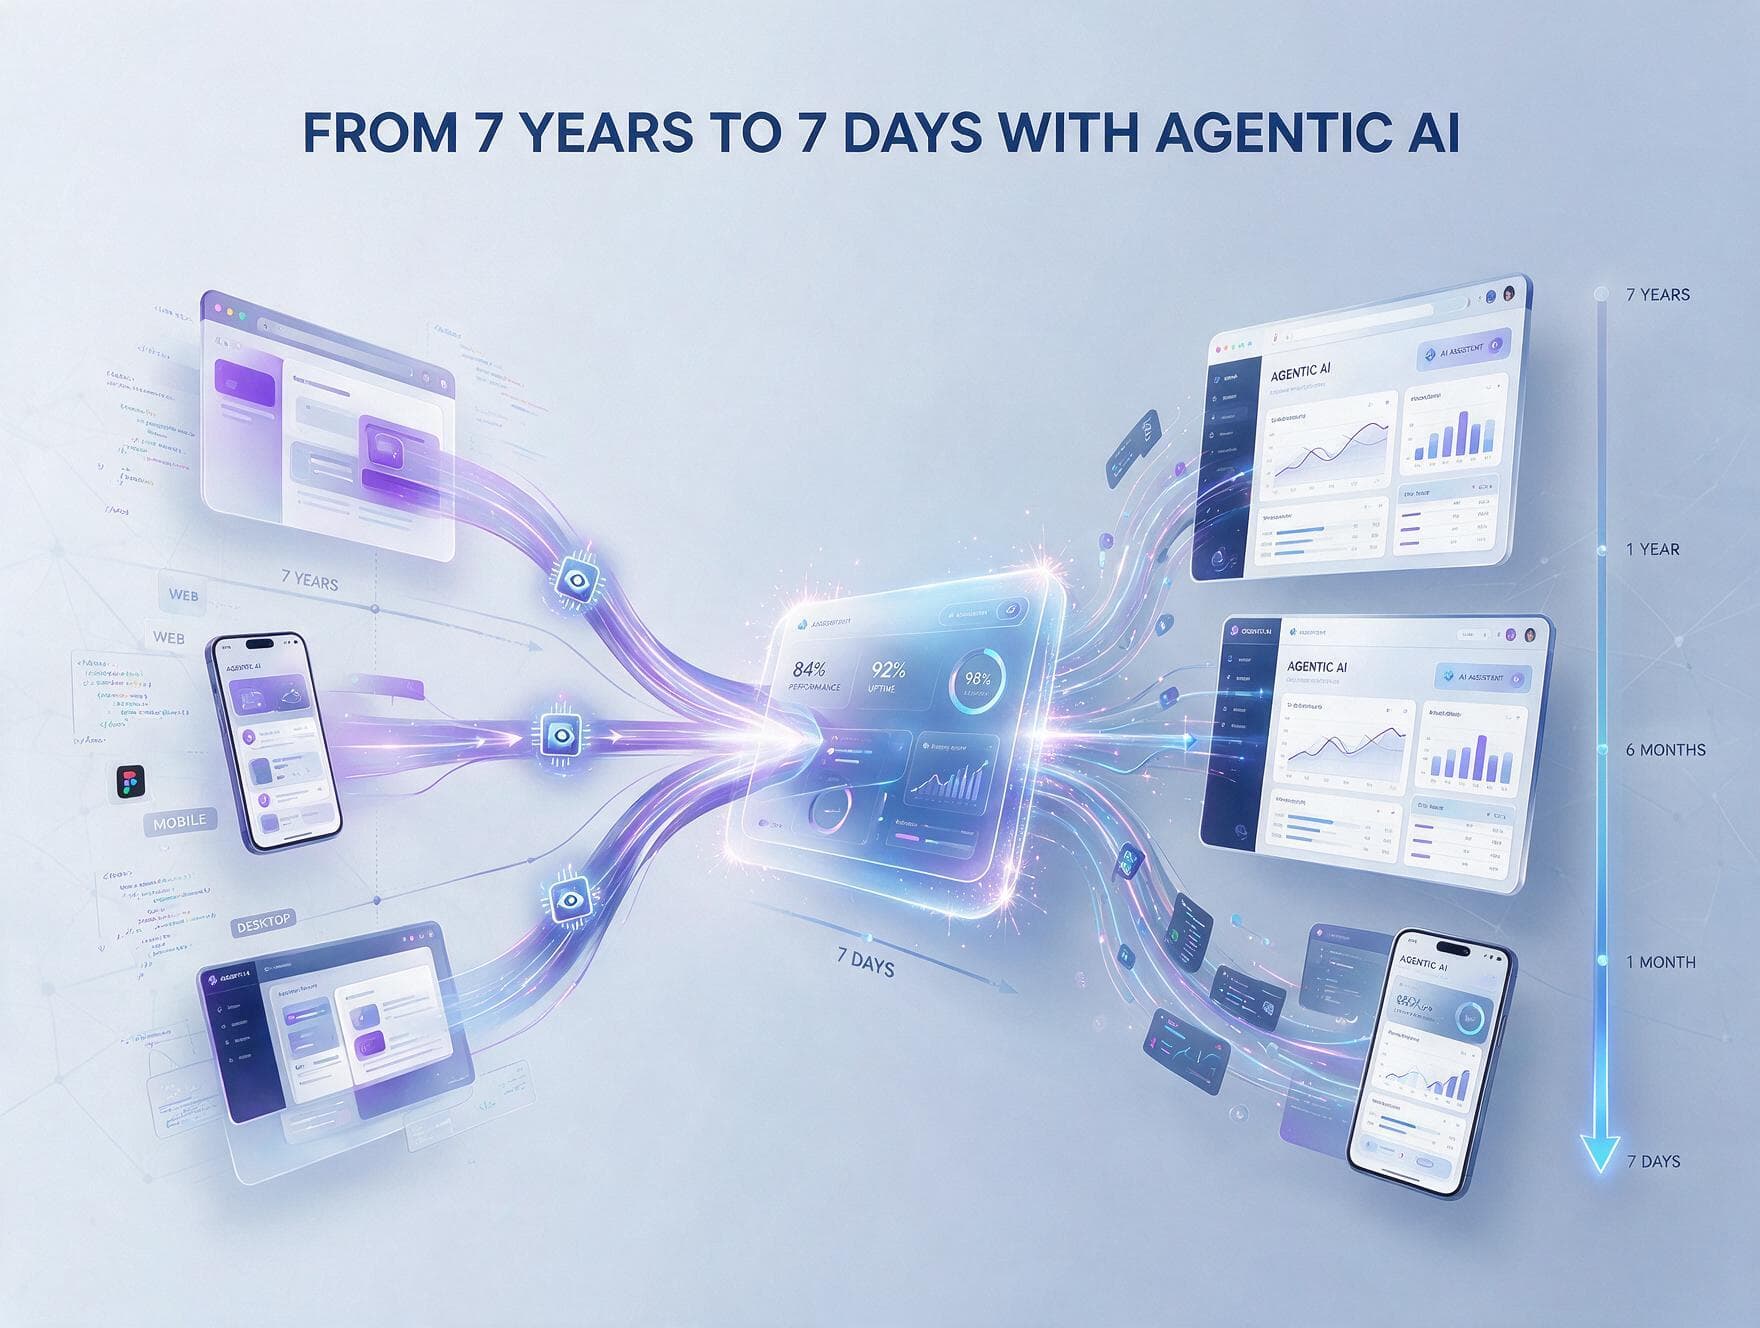
Jika Anda pernah menatap lembar kerja COCOMO II dan melihatnya memprediksi 33 bulan kalender untuk proyek yang dirampungkan tim Anda dalam dua sprint, Anda sudah tahu masalahnya: setiap model estimasi yang digunakan saat ini dikalibrasi di dunia tempat pengembang mengetik setiap baris kode, setiap perpindahan konteks ada ongkosnya, dan kalender berhenti pukul 17.00. Dunia itu sudah tidak ada. Baru-baru ini kami mengembangkan dari nol sebuah aplikasi multisubsistem berukuran 286 KLOC dengan 672 berkas, mencakup lapisan protokol, lapisan data, mesin rendering, dan integrasi platform, lalu mencapai versi alfa yang siap diuji dalam 7 hari. Seluruh panel model (COCOMO Basic/Intermediate/Post-Architecture, Function Points, baseline SLOC, Putnam/SLIM) menghasilkan prediksi median 30,3 bulan kalender. Pengali produktivitas mediannya: 4.240×. Bahkan baseline paling konservatif (25 SLOC per hari kerja pengembang untuk sistem kompleks) meleset sebesar 1.433×. Model-model itu tidak salah. Model-model itu salah diterapkan. Berikut uraian per model, kalibrasi empiris dari penulis yang sama, dan apa yang sebenarnya dikatakan literatur RCT 2024-2026 tentang di mana AI agentik memampatkan durasi, dan di mana tidak.
Proyek yang Menjebol Estimasi
Di RIADVICE, kami baru-baru ini mengembangkan aplikasi kompleks yang kaya fitur, jenis aplikasi yang mengoordinasikan banyak subsistem dalam arsitektur terdistribusi, sebagai lingkungan native lintas platform yang menargetkan perangkat seluler dan desktop dari satu basis kode, didorong oleh kebutuhan pasar yang menuntut implementasi baru. Basis kodenya menunjukkan skalanya:
- 286.662 SLOC (~286 KLOC) yang tersebar di 672 berkas sumber
- 1.329.399 baris total churn: 862.488 penambahan dan 466.911 penghapusan
- 700 commit dalam 7 hari pengembangan aktif hingga mencapai versi alfa pertama yang siap diuji
- Internasionalisasi penuh ke puluhan lokal
- Beberapa subsistem yang sama sekali tidak berkaitan, yaitu penanganan protokol, pengelolaan data, rendering, dan integrasi platform, semuanya dibangun dari nol untuk lingkungan target
Ini bukan sekadar wrapper atau tampilan baru yang tipis. Ini adalah implementasi native yang dibangun dari dasar untuk memenuhi kebutuhan pasar yang tidak dapat dipenuhi solusi yang ada. Sebelum menulis satu baris pun, saya memasang alat analisis khusus ke dalam proyek yang menjalankan seluruh panel model estimasi upaya perangkat lunak standar industri terhadap basis kode seiring pertumbuhannya. Tujuannya jujur: mengukur kesenjangan antara apa yang diprediksi model klasik dan apa yang benar-benar dihasilkan oleh pengerjaan berbantuan AI. Hasilnya bukan selisih pembulatan. Hasilnya adalah patahan kategori.
Prediksi Model Estimasi vs. Kenyataan
Alat ini menjalankan setiap model estimasi utama dalam literatur rekayasa perangkat lunak, yaitu COCOMO Basic (Organic, Semi-Detached, Embedded), COCOMO Intermediate (Semi-Detached dan Embedded, disetel), COCOMO II Post-Architecture (disetel), Function Points, SLOC Productivity Baseline, dan Putnam/SLIM, yang dikalibrasi sesuai jenis proyek menggunakan konstanta yang dipublikasikan dalam literatur sumber aslinya.
| Model estimasi | Prediksi upaya | Prediksi kalender | Percepatan vs. aktual |
|---|---|---|---|
| COCOMO Basic (Organic) | 913 orang-bulan | 33,3 bulan | 2.282× |
| COCOMO Basic (Semi-Detached) | 1.696 orang-bulan | 33,7 bulan | 4.240× |
| COCOMO Basic (Embedded) | 3.200 orang-bulan | 33,1 bulan | 8.000× |
| COCOMO Intermediate (Semi-Det., disetel) | 1.259 orang-bulan | 30,4 bulan | 3.148× |
| COCOMO Intermediate (Embedded, disetel) | 2.376 orang-bulan | 30,1 bulan | 5.940× |
| COCOMO II Post-Architecture (disetel) | 1.703 orang-bulan | 30,3 bulan | 4.257× |
| Function Points (perkiraan kasar) | 17,9 orang-bulan | 7,5 bulan | 45× |
| SLOC Productivity Baseline (25 SLOC/hari kerja) | 573 orang-bulan | 573,3 bulan | 1.433× |
| Putnam/SLIM | dilewati (durasi < 30 hari; suku T 4/3 meledak) | tidak berlaku | tidak berlaku |
Pengali produktivitas median di semua model adalah 4.240×. Bahkan model paling konservatif memprediksi waktu pengerjaan sekitar 1.400 kali lebih lama daripada kenyataannya. Model paling optimistis, Function Points, tetap memprediksi 7,5 bulan kalender, atau 45× lebih lama daripada 7 hari yang sebenarnya. Menurut model-model ini, proyek tersebut seharusnya memakan waktu antara 7 bulan hingga 47 tahun. Versi alfa siap diuji dalam 7 hari.
Model-model itu saling tidak sepakat, dengan selisih 50× hingga 8.000×
Model-model ini tidak sepakat satu sama lain. Pada basis kode yang sama, prediksinya berkisar antara 17,9 hingga 3.200 orang-bulan, atau sebaran 178×. Tolok ukur SEAA 2013 atas COCOMO II, SEER-SEM, SLIM, dan TruePlanning pada 51 proyek nyata menemukan MMRE sebesar 50-100%. Evaluasi tahun 2023 pada dataset COCOMO NASA menemukan MMRE mendekati 1,0 dan PRED(0,25) = 0,0: tidak satu pun proyek yang estimasinya masuk dalam rentang galat 25%. Model-model ini tidak pernah dirancang untuk proyek berbantuan AI. Namun, besarnya kesenjangan ini, bahkan setelah memperhitungkan ketidakakuratan model, menunjukkan bahwa ada sesuatu yang berubah secara struktural.
Apa Kata Riset tentang AI Agentik dan Produktivitas Pengembang
Angka 4.240× itu ekstrem, dan saya tidak ingin membesar-besarkannya. Pembuatan kerangka proyek greenfield menggelembungkan churn, dan SLOC adalah proksi yang lemah untuk nilai. Jadi, mari kita lihat literatur yang telah melalui telaah sejawat. Asisten bergaya Copilot memberikan peningkatan yang moderat namun nyata. Peng dkk. (2023) menemukan bahwa pengembang yang menggunakan AI pair programmer menyelesaikan tugas 55,8% lebih cepat (CI 95%: 21-89%). RCT Microsoft/Accenture/Fortune 100 (2025), studi terbesar hingga saat ini dengan n=4.867, menemukan peningkatan 26% dalam tugas yang diselesaikan. RCT internal Google (2024) menemukan pengurangan waktu pengerjaan tugas sekitar 21%. Eksperimen lapangan BIS/Ant Group (2024) mengukur peningkatan output kode sebesar 55% pada staf junior. Ringkasan jujurnya: 1,26× hingga 1,56× pada tugas yang sesuai. Nyata, tetapi tidak transformatif. AI agentik bekerja dalam rezim yang berbeda. Tinjauan Cognition tahun 2025 tentang Devin melaporkan hasil pelanggan sebesar 10× pada migrasi ETL, 14× pada migrasi versi Java, dan 20× pada perbaikan keamanan. Nubank melaporkan peningkatan efisiensi 12× dan penghematan biaya 20× pada refaktor berskala jutaan baris yang sebelumnya diperkirakan memerlukan upaya bertahun-tahun dari seribu insinyur. Proyek kami berada tepat di rentang ini: histogram commit menunjukkan lonjakan padat pada pukul 22.00, 00.00, dan 01.00, ciri khas sesi yang digerakkan agen. Bukti tandingannya juga nyata. RCT Metr.org tahun 2025 (16 pengembang berpengalaman, 246 tugas pada proyek yang sudah matang) menemukan bahwa AI menambah waktu penyelesaian sebesar 19%: AI memperlambat pengembang berpengalaman pada basis kode yang sudah mereka kenal. Studi difference-in-differences tahun 2026 terhadap 807 repositori GitHub yang mengadopsi alat AI (He dkk., MSR '26) menemukan lonjakan kecepatan yang "sementara" dan peningkatan kompleksitas kode yang "menetap", yang memicu perlambatan jangka panjang. Judulnya sudah menjelaskan semuanya: Speed at the Cost of Quality. Konsensusnya: AI sangat membantu pada pengembangan greenfield dan terstruktur, membantu secara moderat pada tugas penyelesaian kode, dan dapat merugikan kecepatan pada basis kode yang sudah matang. Utang kualitasnya nyata.
Mengapa Model Gagal: Tiga Pergeseran Struktural
Tidak satu pun pendorong biaya dalam model klasik memiliki pengaturan untuk "pengembang memiliki agen otonom yang tidak pernah tidur dan memegang seluruh basis kode dalam konteksnya." Tiga pergeseran meruntuhkan kurva durasi:
- Hambatan mengetik telah hilang.
Model mengasumsikan bahwa sebagian besar upaya bersifat mekanis: boilerplate, kerangka kode, refaktor berulang, sumber daya lokalisasi, dan data terstruktur lainnya. Dalam proyek ini, sebagian besar volumenya berupa teks dan pengkabelan yang sangat teratur, yang dapat dihasilkan atau diubah secara massal oleh agen. Kode yang dulu ditulis tangan, seperti kerangka, konstruktor, dan perekat platform, kini dihasilkan sekaligus dalam jumlah besar, bukan diketik baris demi baris.
- Biaya perpindahan konteks runtuh.
Manusia yang berpindah antara lapisan protokol, lapisan data, dan mesin rendering membayar ongkos memuat konteks setiap kali. Agen yang sudah membaca seluruh repositori berisi 672 berkas hanya membayarnya sekali. Asimetri itu berlipat ganda dengan cepat pada basis kode sebesar ini.
- Kalender bukan lagi hambatan.
Model mengonversi orang-bulan menjadi bulan kalender melalui persamaan penempatan staf yang mengasumsikan hari kerja manusia. Sesi agen berjalan semalaman. Histogram commit menunjukkan output yang berkelanjutan dari pukul 07.00 hingga 01.00: 18 jam aktif, bukan 8.
Kalibrasi Empiris dari Penulis yang Sama
Karena model parametrik saling berselisih hingga beberapa orde besaran, saya juga menjalankan kalibrasi empiris lintas proyek yang membandingkan churn kode saya sendiri per hari kerja sebelum dan sesudah mengadopsi alat AI agentik, pada tiga repositori produksi lain dalam ekosistem yang sama:
| Proyek | Churn/hari kerja sebelum AI | Churn/hari kerja era AI | Pengali |
|---|---|---|---|
| Proyek A (penyeimbang beban) | 673 | 2.056 | 3,1× |
| Proyek B (layanan pelaporan) | 239 | 2.127 | 8,9× |
| Proyek C (layanan pemrosesan) | 1.322 | 982 | 0,7× |
| Agregat (rata-rata / median) | tidak berlaku | tidak berlaku | 4,2× / 3,1× |
Penulis yang sama, domain yang sama, pekerjaan pemeliharaan yang nyata. Pengali empirisnya adalah 3-9×, jauh lebih konservatif daripada angka greenfield 4.240×, dan konsisten dengan batas atas riset AI agentik yang telah dipublikasikan. Satu proyek justru menjadi lebih lambat: peningkatannya bergantung pada jenis tugas, tidak berlaku universal.
Arti Semua Ini bagi Perencanaan Proyek
Jika Anda masih mengestimasi proyek perangkat lunak dengan model yang belum dikalibrasi dan baseline 25 SLOC per hari, estimasi Anda untuk pekerjaan berbantuan AI akan meleset satu hingga tiga orde besaran. Inilah yang kami lakukan di RIADVICE:
- Kalibrasikan dengan riwayat Anda sendiri. Bandingkan output kode Anda sendiri per hari kerja dengan dan tanpa AI. Cara ini lebih murah, lebih jujur, dan menghasilkan rentang 3-9× yang dapat Anda pertanggungjawabkan dalam rencana proyek.
- Pisahkan greenfield dari pemeliharaan. Pengali AI agentik paling besar pada pengembangan greenfield dan terstruktur, dan paling kecil (terkadang negatif) pada pemeliharaan basis kode yang sudah matang. Jangan terapkan satu angka untuk keduanya.
- Anggarkan utang kualitas. Kecepatan AI disertai peningkatan kompleksitas yang menetap. Rencanakan fase pemantapan dan ukur hasilnya: pantau kompleksitas siklomatik dan jalankan deteksi kode salin-tempel pada setiap rilis.
- Estimasikan seluruh kurva, bukan hanya bagian depannya. Peningkatan kecepatan 10× yang menggandakan kepadatan cacat bukanlah peningkatan 10×, melainkan jadwal yang dimajukan dengan harga ekor stabilisasi yang lebih panjang.
Intinya
Proyek yang menurut setiap model estimasi seharusnya memakan waktu 7 bulan hingga 47 tahun mencapai versi alfa yang siap diuji dalam 7 hari. Pengali median 4.240× tidak boleh menjadi rencana proyek siapa pun. Namun, angka ini adalah sinyal jelas bahwa durasi pengembangan perangkat lunak yang kompleks sedang dimampatkan ulang oleh kekuatan yang sama yang memampatkan ulang upaya. Riset yang dipublikasikan menunjukkan AI memberikan apa saja mulai dari dorongan 1,26× hingga lonjakan 20×, dengan risiko nyata berupa imbal hasil negatif pada basis kode yang sudah matang dan ongkos kualitas yang terukur. Model-model yang mengatakan proyek ini seharusnya memakan waktu puluhan tahun adalah model yang sama yang masih berjalan di lembar kerja estimasi perusahaan hari ini. Pertanyaannya bukan apakah AI agentik mengubah durasi proyek; riset sudah menjawabnya. Pertanyaannya adalah apakah praktik estimasi Anda sudah mengejar bukti tersebut. Jika angka Anda masih berasal dari model tahun 1981 yang dikalibrasi pada COBOL dan assembly, sudah saatnya melakukan kalibrasi ulang, atau setidaknya berhenti memercayai kalender yang dicetaknya.
"Masih ada ruang perbaikan yang signifikan agar tantangan prediksi yang dihadapi dalam praktik dapat ditangani dengan lebih baik."
Accuracy of Contemporary Parametric Software Estimation Models, SEAA 2013
🏆 Keahlian Rekayasa & Cloud Tepercaya
RIADVICE: Mitra Tepercaya Anda dalam Rekayasa Perangkat Lunak
Kami merancang, membangun, dan menerapkan sistem perangkat lunak yang kompleks dengan disiplin rekayasa dan perkakas untuk berkarya di era AI: tepat waktu, sesuai anggaran, dan sesuai standar kualitas.
Pelajari Layanan Kami Lebih Lanjut →
📚 Sumber & Bacaan Lanjutan
Artikel ini bersumber dari riset yang telah melalui telaah sejawat, uji coba terkontrol secara acak, dan laporan lapangan industri tentang produktivitas pengembangan perangkat lunak berbantuan AI dan estimasi upaya perangkat lunak:
- Studi Produktivitas AI (RCT dan Eksperimen Lapangan)
- Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot, arXiv:2302.06590: pengurangan waktu penyelesaian tugas sebesar 55,8%
- Cui, R., et al. (2025). The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers Microsoft Research: n=4.867, tugas yang diselesaikan +26,08%
- Dam, S., et al. (2024). How much does AI impact development speed? An enterprise-based randomized controlled trial, arXiv:2410.12944: RCT Google, n=96, pengurangan waktu pengerjaan tugas sekitar 21%
- Becker, B., et al. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity Metr.org: RCT, n=16, 246 tugas; AI menambah waktu penyelesaian sebesar 19%
- He, H., Miller, C., Agarwal, S., Kästner, C., & Vasilescu, B. (2026). Speed at the Cost of Quality: How Cursor AI Increases Short-Term Velocity and Long-Term Complexity in Open-Source Projects, arXiv:2511.04427: studi DiD terhadap 807 repositori GitHub; MSR '26
- Evolver Business Solutions (2026). For a few tokens more: The productivity effect of AI tools on software development tasks Replikasi dengan temuan +13% (tidak signifikan)
- Laporan Industri AI Agentik
- Cognition AI (2025). Devin's 2025 Performance Review: Learnings From 18 Months of Agents At Work 10× pada migrasi ETL, 14× pada migrasi Java, 20× pada perbaikan keamanan
- Nubank / Cognition. How Nubank refactors millions of lines of code to improve engineering efficiency with Devin 12× jam kerja rekayasa, penghematan biaya 20× pada refaktor berskala jutaan baris
- BIS / Ant Group (2024). Eksperimen lapangan; output kode +55%, terutama pada staf junior
- Estimasi Upaya Perangkat Lunak: Landasan dan Akurasi
- Boehm, B. W. (1981). Software Engineering Economics. Prentice Hall: COCOMO orisinal
- Boehm, B. W., Abts, C., & Chulani, S. (2000). Software Cost Estimation with COCOMO II. Prentice Hall: dikalibrasi pada 161 proyek
- SEAA 2013. Accuracy of Contemporary Parametric Software Estimation Models COCOMO II, SEER-SEM, SLIM, TruePlanning pada 51 proyek; MMRE 50-100%
- Kemerer, C. F. (1993). An empirical validation of software cost estimation models, Communications of the ACM
- Nguyen, V., et al. (2019). Determining relevant training data for effort estimation using window-based COCOMO calibration Kalibrasi berbasis jendela pada 341 + 93 proyek
- Ahmad, M., & Wani, M. A. (2023). Evaluation of COCOMO Model Accuracy in Software Effort Estimation MMRE ~1,0, PRED(0,25) = 0,0
- Putnam, L. H. (1978). A general empirical solution to the macro software sizing and estimation problem. IEEE TSE: model Putnam/SLIM
⚡ RIADVICE.com menghadirkan rekayasa tepercaya, keahlian cloud, dan solusi perangkat lunak kelas perusahaan: tepat waktu, sesuai anggaran, dan sesuai standar kualitas.