Dalam artikel ini
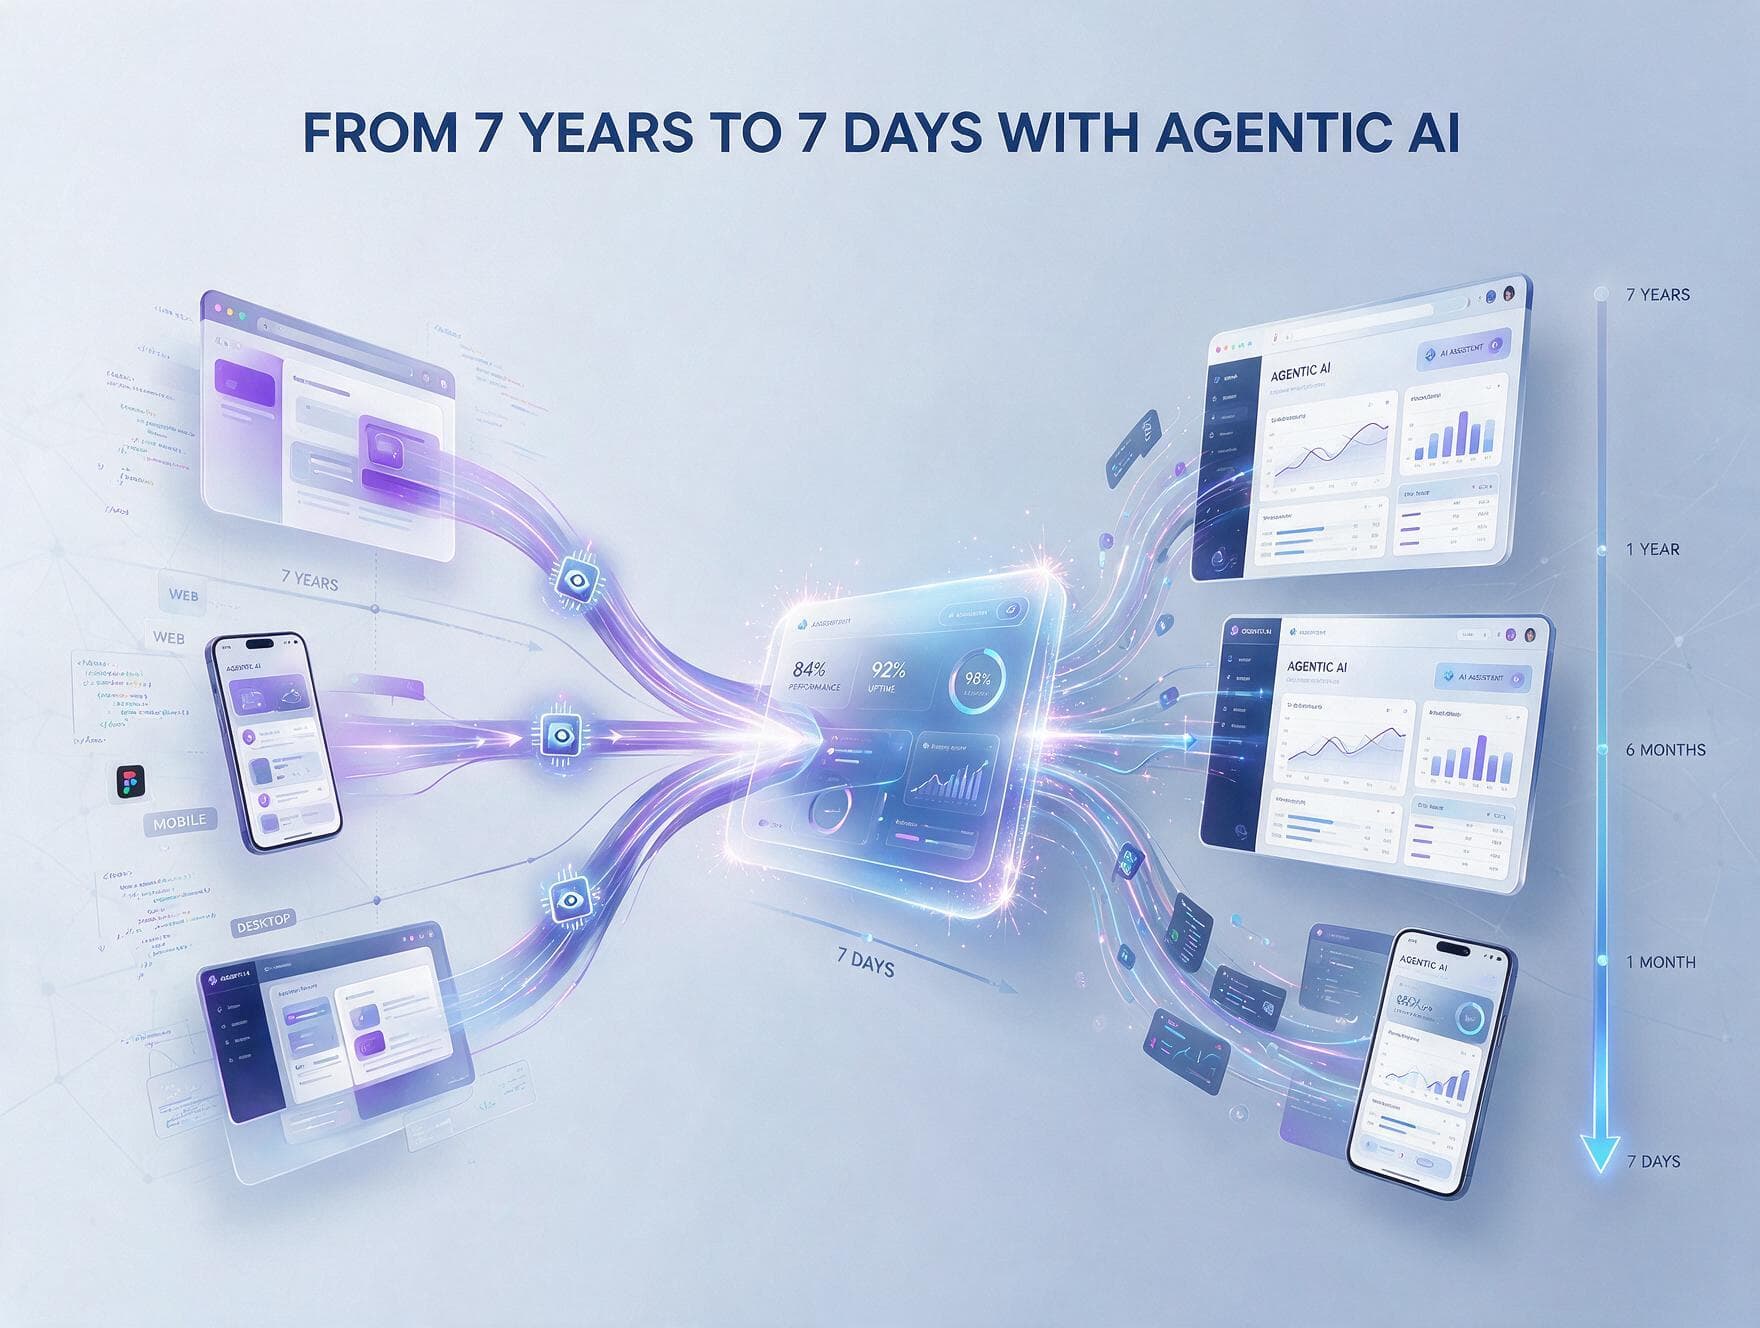
Jika anda pernah menatap hamparan COCOMO II dan melihatnya meramalkan 33 bulan kalendar untuk projek yang dihantar oleh pasukan anda dalam dua sprint, anda sudah tahu masalahnya: setiap model anggaran yang digunakan hari ini dikalibrasi untuk dunia di mana pembangun menaip setiap baris, pertukaran konteks ada kosnya, dan kalendar berhenti pada pukul 5 petang. Dunia itu sudah tiada. Kami baru-baru ini membangunkan aplikasi berbilang subsistem bersaiz 286 KLOC dengan 672 fail dari awal (lapisan protokol, lapisan data, enjin pemaparan, integrasi platform) dan mencapai versi alfa yang sedia untuk diuji dalam masa 7 hari. Panel model penuh (COCOMO Basic/Intermediate/Post-Architecture, Function Points, garis dasar SLOC, Putnam/SLIM) memberikan ramalan median sebanyak 30.3 bulan kalendar. Pengganda produktiviti median: 4,240×. Malah garis dasar yang paling konservatif (25 SLOC/hari pembangun untuk sistem kompleks) tersasar sebanyak 1,433×. Model-model ini tidak salah. Ia digunakan secara tidak tepat. Di bawah ialah pecahan bagi setiap model, kalibrasi empirikal oleh pengarang yang sama, dan apa yang sebenarnya dinyatakan oleh literatur RCT 2024 hingga 2026 tentang di mana AI agentik memampatkan tempoh, dan di mana ia tidak.
Projek yang Mematahkan Anggaran
Di RIADVICE, kami baru-baru ini membangunkan aplikasi yang kompleks dan kaya dengan ciri, iaitu jenis aplikasi yang menyelaraskan pelbagai subsistem merentas seni bina teragih, sebagai persekitaran asli merentas platform yang menyasarkan peranti mudah alih dan desktop daripada satu pangkalan kod, didorong oleh keperluan pasaran yang menuntut pelaksanaan baharu. Pangkalan kodnya menunjukkan skalanya:
- 286,662 SLOC (~286 KLOC) yang tersebar dalam 672 fail sumber
- 1,329,399 baris jumlah churn: 862,488 sisipan dan 466,911 pemadaman
- 700 commit dalam 7 hari pembangunan aktif untuk mencapai versi alfa pertama yang sedia untuk diuji
- Pengantarabangsaan penuh ke dalam berpuluh-puluh lokal
- Pelbagai subsistem yang sama sekali tidak berkaitan (pengendalian protokol, pengurusan data, pemaparan dan integrasi platform), kesemuanya dibina dari awal untuk persekitaran sasaran
Ini bukan pembalut atau sekadar penukaran rupa yang nipis. Ia ialah pelaksanaan asli yang dibina dari asas untuk memenuhi keperluan pasaran yang tidak dapat dipenuhi oleh penyelesaian sedia ada. Sebelum menulis satu baris pun, saya memasang alat analisis tersuai ke dalam projek yang menjalankan panel penuh model anggaran usaha perisian piawaian industri terhadap pangkalan kod semasa ia berkembang. Matlamatnya jujur: mengukur jurang antara apa yang diramalkan oleh model klasik dan apa yang sebenarnya dihasilkan oleh penghantaran berbantukan AI. Keputusannya bukan sekadar ralat pembundaran. Ia ialah satu perubahan kategori.
Apa yang Diramalkan oleh Model Anggaran berbanding Apa yang Sebenarnya Berlaku
Alat ini menjalankan setiap model anggaran utama dalam literatur kejuruteraan perisian: COCOMO Basic (Organic, Semi-Detached, Embedded), COCOMO Intermediate (Semi-Detached dan Embedded, ditala), COCOMO II Post-Architecture (ditala), Function Points, SLOC Productivity Baseline dan Putnam/SLIM, yang dikalibrasi mengikut jenis projek menggunakan pemalar yang diterbitkan daripada literatur sumber asal.
| Model anggaran | Ramalan usaha | Ramalan kalendar | Pecutan berbanding sebenar |
|---|---|---|---|
| COCOMO Basic (Organic) | 913 bulan-orang | 33.3 bulan | 2,282× |
| COCOMO Basic (Semi-Detached) | 1,696 bulan-orang | 33.7 bulan | 4,240× |
| COCOMO Basic (Embedded) | 3,200 bulan-orang | 33.1 bulan | 8,000× |
| COCOMO Intermediate (Semi-Det., ditala) | 1,259 bulan-orang | 30.4 bulan | 3,148× |
| COCOMO Intermediate (Embedded, ditala) | 2,376 bulan-orang | 30.1 bulan | 5,940× |
| COCOMO II Post-Architecture (ditala) | 1,703 bulan-orang | 30.3 bulan | 4,257× |
| Function Points (anggaran kasar) | 17.9 bulan-orang | 7.5 bulan | 45× |
| SLOC Productivity Baseline (25 SLOC/hari pembangun) | 573 bulan-orang | 573.3 bulan | 1,433× |
| Putnam/SLIM | dilangkau (tempoh < 30 hari; T 4/3 meletup) | t/b | t/b |
Pengganda produktiviti median merentas semua model ialah 4,240×. Malah model yang paling konservatif meramalkan masa penghantaran kira-kira 1,400 kali lebih lama daripada apa yang berlaku. Model yang paling optimistik, Function Points, masih meramalkan 7.5 bulan kalendar, iaitu 45× lebih lama daripada 7 hari sebenar. Model-model ini menyatakan bahawa projek ini sepatutnya mengambil masa antara 7 bulan hingga 47 tahun. Versi alfa sedia untuk diuji dalam 7 hari.
Model-model ini saling bercanggah, sebanyak 50× hingga 8,000×
Model-model ini tidak bersetuju antara satu sama lain. Pada pangkalan kod yang sama, ramalan berjulat daripada 17.9 hingga 3,200 bulan-orang, iaitu sebaran 178×. Penanda aras SEAA 2013 bagi COCOMO II, SEER-SEM, SLIM dan TruePlanning merentas 51 projek sebenar mendapati MMRE sebanyak 50 hingga 100%. Satu penilaian pada 2023 terhadap set data COCOMO NASA mendapati MMRE hampir 1.0 dan PRED(0.25) = 0.0: tiada satu projek pun dianggarkan dalam jalur ralat 25%. Model-model ini tidak pernah direka untuk projek berbantukan AI. Namun saiz jurangnya, walaupun selepas mengambil kira ketidaktepatan model, memberitahu kita bahawa sesuatu yang struktural telah berubah.
Apa Sebenarnya Kata Penyelidikan tentang AI Agentik dan Produktiviti Pembangun
Angka 4,240× itu ekstrem, dan saya tidak mahu membesar-besarkannya. Perancahan projek baharu (greenfield) menggelembungkan churn, dan SLOC ialah proksi nilai yang lemah. Jadi mari kita lihat literatur yang disemak rakan sebidang. Pembantu gaya Copilot memberikan keuntungan yang sederhana tetapi nyata. Peng et al. (2023) mendapati pembangun yang menggunakan pengaturcara pasangan AI menyiapkan tugasan 55.8% lebih pantas (95% CI: 21 hingga 89%). RCT Microsoft/Accenture/Fortune 100 (2025), kajian terbesar setakat ini dengan n=4,867, mendapati peningkatan 26% dalam tugasan yang disiapkan. RCT dalaman Google (2024) mendapati pengurangan ~21% dalam masa menyiapkan tugasan. Eksperimen lapangan BIS/Ant Group (2024) mengukur peningkatan 55% dalam output kod bagi kakitangan junior. Ringkasan yang jujur: 1.26× hingga 1.56× pada tugasan yang sesuai. Nyata, tetapi tidak transformatif. AI agentik beroperasi dalam rejim yang berbeza. Kajian semula Devin oleh Cognition pada 2025 melaporkan keputusan pelanggan sebanyak 10× untuk migrasi ETL, 14× untuk migrasi versi Java dan 20× untuk pembaikan keselamatan. Nubank melaporkan peningkatan kecekapan 12× dan penjimatan kos 20× pada pemfaktoran semula berjuta-juta baris yang sebelum ini dianggarkan sebagai usaha bertahun-tahun melibatkan seribu jurutera. Projek kami berada tepat dalam julat ini: histogram commit menunjukkan ledakan padat pada pukul 22:00, 00:00 dan 01:00, tanda sesi yang dipacu oleh ejen. Bukti sebaliknya juga nyata. RCT Metr.org pada 2025 (16 pembangun berpengalaman, 246 tugasan pada projek matang) mendapati AI meningkatkan masa penyiapan sebanyak 19%: ia memperlahankan pembangun berpengalaman pada pangkalan kod yang biasa bagi mereka. Kajian perbezaan-dalam-perbezaan 2026 terhadap 807 repositori GitHub yang menerima pakai alat AI (He et al., MSR ’26) mendapati lonjakan kelajuan yang “sementara” dan peningkatan “berterusan” dalam kerumitan kod yang menyebabkan kelembapan jangka panjang. Tajuknya mengatakan segala-galanya: Speed at the Cost of Quality. Konsensusnya: AI banyak membantu dalam pembangunan baharu dan berstruktur, membantu secara sederhana dalam tugasan penyiapan, dan boleh menjejaskan kelajuan pada pangkalan kod yang matang. Hutang kualiti itu nyata.
Mengapa Model Gagal: Tiga Anjakan Struktural
Tiada satu pun pemacu kos dalam model klasik mempunyai tetapan untuk “pembangun mempunyai ejen autonomi yang tidak pernah tidur dan memegang keseluruhan pangkalan kod dalam konteksnya.” Tiga anjakan meruntuhkan lengkung tempoh:
- Kesesakan menaip sudah tiada.
Model mengandaikan sebahagian besar usaha bersifat mekanikal: kod boilerplate, perancahan, pemfaktoran semula berulang, sumber penyetempatan dan data berstruktur yang lain. Dalam projek ini, sebahagian besar volumnya ialah teks dan pendawaian yang sangat teratur yang boleh dijana atau diubah oleh ejen secara pukal. Kod yang dibina dengan tangan itu sendiri (perancahan, konstruktor, perekat platform) kini dijana secara berkelompok, bukan ditaip baris demi baris.
- Kos pertukaran konteks semakin runtuh.
Manusia yang bertukar antara lapisan protokol, lapisan data dan enjin pemaparan membayar “cukai” memuatkan konteks setiap kali. Ejen yang telah membaca keseluruhan repositori 672 fail membayarnya sekali sahaja. Ketidaksimetrian itu berganda dengan cepat pada pangkalan kod sebesar ini.
- Kalendar bukan lagi kesesakannya.
Model menukar bulan-orang kepada bulan kalendar melalui persamaan perjawatan yang mengandaikan hari bekerja manusia. Sesi ejen berjalan semalaman. Histogram commit menunjukkan output berterusan dari pukul 07:00 hingga 01:00: 18 jam aktif, bukan 8.
Kalibrasi Empirikal oleh Pengarang yang Sama
Model parametrik bercanggah sehingga beberapa tertib magnitud, jadi saya juga menjalankan kalibrasi empirikal merentas projek yang membandingkan churn kod saya sendiri bagi setiap hari-orang sebelum dan selepas menerima pakai alat AI agentik, pada tiga repositori produksi lain dalam ekosistem yang sama:
| Projek | Churn/hari pembangun sebelum AI | Churn/hari pembangun era AI | Pengganda |
|---|---|---|---|
| Projek A (pengimbang beban) | 673 | 2,056 | 3.1× |
| Projek B (perkhidmatan pelaporan) | 239 | 2,127 | 8.9× |
| Projek C (perkhidmatan pemprosesan) | 1,322 | 982 | 0.7× |
| Agregat (purata / median) | 4.2× / 3.1× |
Pengarang yang sama, domain yang sama, kerja penyelenggaraan sebenar. Pengganda empirikalnya ialah 3 hingga 9×, jauh lebih konservatif daripada angka 4,240× bagi projek baharu, dan konsisten dengan hujung atas penyelidikan AI agentik yang diterbitkan. Satu projek sebenarnya menjadi lebih perlahan: keuntungannya bergantung pada tugasan, bukan sejagat.
Apa Maknanya untuk Perancangan Projek
Jika anda masih menganggarkan projek perisian dengan model yang tidak dikalibrasi dan garis dasar 25 SLOC sehari, anggaran anda akan tersasar sebanyak satu hingga tiga tertib magnitud bagi kerja berbantukan AI. Inilah yang kami lakukan di RIADVICE:
- Kalibrasi berdasarkan sejarah anda sendiri. Bandingkan output kod anda sendiri bagi setiap hari-orang dengan dan tanpa AI. Ia lebih murah, lebih jujur, dan menghasilkan julat 3 hingga 9× yang boleh anda pertahankan dalam pelan projek.
- Asingkan projek baharu daripada penyelenggaraan. Pengganda AI agentik paling besar pada pembangunan baharu dan berstruktur, dan paling kecil (kadangkala negatif) pada penyelenggaraan pangkalan kod yang matang. Jangan gunakan satu angka untuk kedua-duanya.
- Peruntukkan bajet untuk hutang kualiti. Kelajuan AI datang bersama peningkatan kerumitan yang berterusan. Rancang fasa pengukuhan dan pantaunya: jejaki kerumitan siklomatik dan jalankan pengesanan salin-tampal pada setiap keluaran.
- Anggarkan keseluruhan lengkung, bukan bahagian hadapannya sahaja. Keuntungan kelajuan 10× yang menggandakan ketumpatan kecacatan anda bukanlah keuntungan 10×: ia ialah jadual yang ditarik ke hadapan dengan kos tempoh penstabilan yang lebih panjang.
Kesimpulannya
Sebuah projek yang menurut setiap model anggaran sepatutnya mengambil masa 7 bulan hingga 47 tahun telah mencapai versi alfa yang sedia untuk diuji dalam 7 hari. Pengganda median 4,240× tidak sepatutnya menjadi pelan projek sesiapa. Namun ia ialah isyarat jelas bahawa tempoh pembangunan perisian yang kompleks sedang dimampatkan semula oleh kuasa yang sama yang memampatkan semula usaha. Penyelidikan yang diterbitkan menunjukkan AI memberikan apa sahaja daripada dorongan 1.26× hingga lonjakan 20×, dengan risiko nyata pulangan negatif pada pangkalan kod yang matang dan “cukai” kualiti yang boleh diukur. Model yang memberitahu kita bahawa projek ini sepatutnya mengambil masa berdekad-dekad ialah model yang sama yang masih digunakan dalam hamparan anggaran perusahaan hari ini. Persoalannya bukan sama ada AI agentik mengubah tempoh projek; penyelidikan telah menjawabnya. Persoalannya ialah sama ada amalan anggaran anda telah mengikuti perkembangan bukti. Jika angka anda masih datang daripada model tahun 1981 yang dikalibrasi pada COBOL dan bahasa himpunan, sudah tiba masanya untuk membuat kalibrasi semula, atau sekurang-kurangnya berhenti mempercayai kalendar yang dicetaknya.
“Masih terdapat ruang yang besar untuk penambahbaikan bagi menangani cabaran ramalan yang dihadapi dalam amalan dengan lebih baik.”
Accuracy of Contemporary Parametric Software Estimation Models, SEAA 2013
🏆 Kepakaran Kejuruteraan & Awan yang Dipercayai
RIADVICE: Rakan Kongsi Dipercayai Anda dalam Kejuruteraan Perisian
Kami mereka bentuk, membina dan melaksanakan sistem perisian yang kompleks dengan disiplin kejuruteraan dan alatan untuk menghantar pada era AI: tepat pada masanya, mengikut bajet dan menepati kualiti.
Ketahui Lebih Lanjut tentang Perkhidmatan Kami →
📚 Sumber & Bacaan Lanjut
Artikel ini berpandukan penyelidikan yang disemak rakan sebidang, percubaan terkawal rawak dan laporan lapangan industri tentang produktiviti pembangunan perisian berbantukan AI serta anggaran usaha perisian:
- Kajian Produktiviti AI (RCT dan Eksperimen Lapangan)
- Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot, arXiv:2302.06590: pengurangan 55.8% dalam masa menyiapkan tugasan
- Cui, R., et al. (2025). The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers Microsoft Research: n=4,867, +26.08% tugasan disiapkan
- Dam, S., et al. (2024). How much does AI impact development speed? An enterprise-based randomized controlled trial, arXiv:2410.12944: RCT Google, n=96, pengurangan ~21% dalam masa menyiapkan tugasan
- Becker, B., et al. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity Metr.org: RCT, n=16, 246 tugasan; AI meningkatkan masa penyiapan sebanyak 19%
- He, H., Miller, C., Agarwal, S., Kästner, C., & Vasilescu, B. (2026). Speed at the Cost of Quality: How Cursor AI Increases Short-Term Velocity and Long-Term Complexity in Open-Source Projects, arXiv:2511.04427: kajian DiD terhadap 807 repositori GitHub; MSR ’26
- Evolver Business Solutions (2026). For a few tokens more: The productivity effect of AI tools on software development tasks Dapatan replikasi +13% (tidak signifikan)
- Laporan Industri AI Agentik
- Cognition AI (2025). Devin’s 2025 Performance Review: Learnings From 18 Months of Agents At Work 10× migrasi ETL, 14× migrasi Java, 20× pembaikan keselamatan
- Nubank / Cognition. How Nubank refactors millions of lines of code to improve engineering efficiency with Devin 12× jam kejuruteraan, penjimatan kos 20× pada pemfaktoran semula berjuta-juta baris
- BIS / Ant Group (2024). Eksperimen lapangan; +55% output kod, tertumpu dalam kalangan kakitangan junior
- Anggaran Usaha Perisian: Asas dan Ketepatan
- Boehm, B. W. (1981). Software Engineering Economics. Prentice Hall: COCOMO asal
- Boehm, B. W., Abts, C., & Chulani, S. (2000). Software Cost Estimation with COCOMO II. Prentice Hall: dikalibrasi pada 161 projek
- SEAA 2013. Accuracy of Contemporary Parametric Software Estimation Models COCOMO II, SEER-SEM, SLIM, TruePlanning merentas 51 projek; MMRE 50 hingga 100%
- Kemerer, C. F. (1993). An empirical validation of software cost estimation models, Communications of the ACM
- Nguyen, V., et al. (2019). Determining relevant training data for effort estimation using window-based COCOMO calibration Kalibrasi berasaskan tetingkap merentas 341 + 93 projek
- Ahmad, M., & Wani, M. A. (2023). Evaluation of COCOMO Model Accuracy in Software Effort Estimation MMRE ~1.0, PRED(0.25) = 0.0
- Putnam, L. H. (1978). A general empirical solution to the macro software sizing and estimation problem. IEEE TSE: model Putnam/SLIM
⚡ RIADVICE.com menyediakan kejuruteraan yang dipercayai, kepakaran awan dan penyelesaian perisian bertaraf perusahaan: tepat pada masanya, mengikut bajet dan menepati kualiti.